Quando modelli e agenti entrano nei workflow, qualità e sicurezza dipendono da ruoli, soglie ed escalation definiti prima che arrivi l’errore.
Un modello può superare i test interni, impressionare durante la demo e produrre comunque un disastro organizzativo poche settimane dopo il lancio. La causa emerge spesso fuori dal codice: nessuno sa con precisione chi debba controllare le sue azioni, quando sia richiesta un’approvazione e chi abbia l’autorità per fermare il processo.
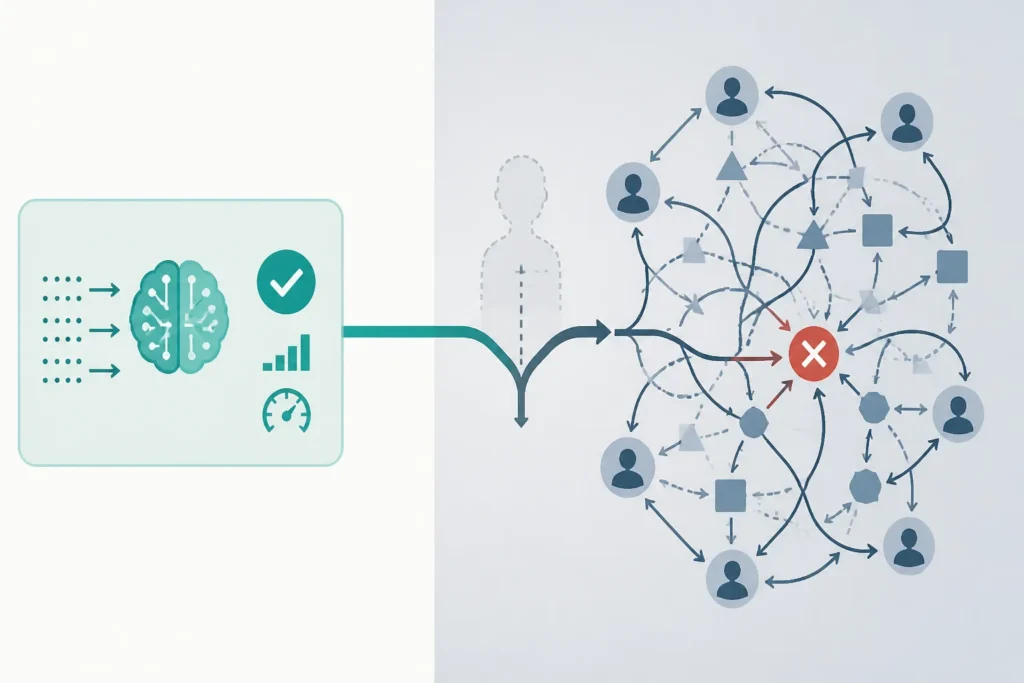
L’adozione dell’AI viene ancora raccontata come una scelta di strumenti. Si seleziona un modello, lo si collega ai dati aziendali e si misura la qualità delle risposte. In produzione, però, il sistema entra in una rete di persone, responsabilità e scadenze. Ogni errore può attraversare quella rete e trasformarsi in una decisione, una comunicazione esterna o un’azione su un software aziendale.
La domanda decisiva cambia quindi forma. La valutazione tecnica resta essenziale, mentre il successo operativo dipende sempre di più da chi osserva il sistema, chi corregge le anomalie e chi risponde delle conseguenze. Senza un protocollo di supervisione, anche un modello capace rimane inserito in un’organizzazione impreparata a governarlo.
La demo misura il modello, la produzione misura l’organizzazione
Durante una sperimentazione, il gruppo di progetto conosce il perimetro del test e guarda con attenzione quasi ogni risultato. Gli errori vengono discussi rapidamente, gli utenti hanno aspettative prudenti e il volume delle operazioni resta contenuto. Questa condizione crea una supervisione informale molto efficace, sostenuta dalla presenza costante delle persone che hanno costruito il progetto.
Il quadro cambia con il passaggio alla produzione. I volumi crescono, gli utenti si moltiplicano e il sistema incontra casi più vari. Le persone che avevano seguito il test tornano alle proprie attività, mentre il controllo quotidiano viene distribuito tra team diversi. È qui che molte iniziative perdono affidabilità: la supervisione esisteva come attenzione straordinaria del gruppo iniziale e non è stata trasformata in un processo stabile.
Un assistente che prepara risposte per il servizio clienti richiede criteri di revisione coerenti. Un sistema editoriale deve sapere quali contenuti possono arrivare alla pubblicazione e quali richiedono un passaggio umano. Un agente che interviene in un repository ha bisogno di permessi graduati e di una procedura di ripristino. In ciascun caso, la qualità del modello rappresenta una parte dell’equazione. Il resto riguarda il disegno del lavoro attorno al sistema.
Che cosa contiene un protocollo di supervisione
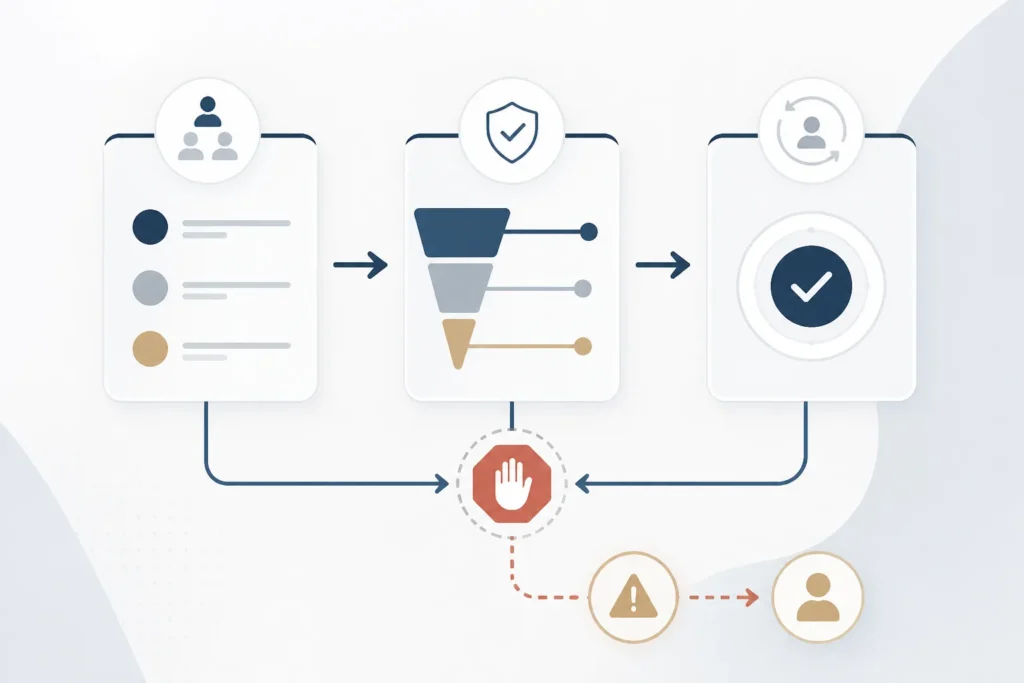
Un protocollo di supervisione traduce principi generali come controllo umano e accountability in decisioni operative. Assegna ruoli reali, stabilisce la frequenza delle verifiche e definisce le condizioni che attivano un intervento. Deve essere comprensibile alle persone coinvolte e applicabile anche durante un picco di lavoro, un’assenza o un incidente.
Il primo elemento è una mappa dell’autorità. Il process owner valuta l’impatto sul flusso di lavoro. Lo specialista di dominio giudica la correttezza del risultato. Il team tecnico interviene sul comportamento del sistema e sulla sua configurazione. Questi ruoli possono appartenere a funzioni diverse, purché ogni decisione abbia un proprietario identificabile.
Il secondo elemento riguarda tempi e soglie. Una revisione continua di ogni singolo output diventa rapidamente insostenibile. La supervisione può quindi seguire il rischio: campionamento per le attività a basso impatto, approvazione obbligatoria per le operazioni sensibili e arresto automatico in presenza di anomalie definite. Le soglie devono derivare dalle conseguenze possibili, oltre che dal livello medio di accuratezza osservato nei test.
Il terzo elemento è la traccia delle decisioni. Log, versioni e registri delle approvazioni consentono di ricostruire che cosa è accaduto e con quali informazioni. Questa memoria operativa serve durante gli audit e offre materiale prezioso per migliorare il sistema. Un errore documentato può diventare una nuova regola, un test aggiuntivo o una modifica dei permessi.
Supervisionare significa guardare oltre il risultato finale
Molti controlli si concentrano sull’output: il testo è corretto, il codice funziona, la classificazione appare plausibile. Questa revisione intercetta una parte dei problemi. Un sistema AI può produrre un risultato apparentemente valido attraverso un processo fragile, usando una fonte inadeguata oppure accedendo a informazioni che il singolo utente avrebbe dovuto ignorare.
La supervisione del processo osserva quindi il percorso seguito dal sistema. Quali dati ha consultato? Quali strumenti ha attivato? Quanto si è discostato dal comportamento abituale? Per gli agenti software, queste domande assumono un peso particolare perché il sistema può concatenare azioni e modificare l’ambiente prima dell’arrivo di una verifica umana.
Esiste poi il livello della responsabilità finale. Il protocollo deve indicare chi decide dopo un’escalation e quali poteri possiede. Un supervisore privo della possibilità di sospendere il workflow svolge una funzione puramente simbolica. Allo stesso modo, un responsabile chiamato a intervenire senza accesso ai log riceve un titolo privo degli strumenti necessari.
Il concetto di human-in-the-loop acquista valore concreto quando specifica il momento dell’intervento, le informazioni disponibili e l’azione consentita. La presenza astratta di una persona nel diagramma offre poche garanzie. La progettazione del suo ruolo determina la reale capacità di controllo.
Gli agenti rendono la supervisione una funzione continua
Con un chatbot tradizionale, l’utente vede la risposta e può valutarla prima di usarla. Un agente introduce un livello operativo ulteriore: pianifica passaggi, chiama strumenti e aggiorna sistemi esterni. La velocità diventa un vantaggio e amplifica allo stesso tempo la distanza tra l’avvio del compito e la verifica umana.
Questa evoluzione spiega perché il mercato enterprise parla sempre più spesso di auditabilità, telemetria e ambienti separati. Le guide di Microsoft, OpenAI e AWS affrontano da prospettive diverse la stessa esigenza: portare il controllo lungo l’intero ciclo di vita del sistema. Il segnale strategico supera le singole funzioni di prodotto. L’AI aziendale sta diventando un’infrastruttura operativa e richiede pratiche paragonabili a quelle già applicate ai servizi critici.
La separazione tra sperimentazione e produzione svolge un ruolo centrale. In un ambiente controllato si possono esplorare capacità, osservare errori e calibrare i permessi. L’accesso ai processi reali arriva per gradi, insieme a evidenze verificabili. Ogni aumento di autonomia dovrebbe corrispondere a una maggiore capacità di osservazione e recupero.
Anche la continuità operativa entra nel protocollo. Se il supervisore principale è assente, serve un sostituto. Se la telemetria smette di funzionare, il sistema deve passare a una modalità più prudente. Se un fornitore aggiorna il modello, occorre stabilire quali test ripetere prima di mantenere lo stesso livello di autonomia. La supervisione vive nel tempo e segue l’evoluzione del sistema.
Il rischio umano della supervisione di facciata
Affidare il controllo a una persona risolve poco quando il lavoro è monotono, il volume è eccessivo o le responsabilità restano vaghe. Dopo centinaia di risultati plausibili, l’attenzione cala e l’approvazione può trasformarsi in un gesto automatico. Il protocollo deve considerare anche questa fragilità umana.
Una buona progettazione concentra l’attenzione sui casi che meritano davvero giudizio. Il sistema può segnalare deviazioni, raggruppare eventi simili e attribuire priorità secondo il rischio. Il supervisore riceve così un contesto leggibile e dispone del tempo necessario per decidere. L’automazione contribuisce alla supervisione, mentre la responsabilità rimane assegnata a persone e funzioni riconoscibili.
La formazione cambia di conseguenza. Conoscere il prompt o l’interfaccia rappresenta una competenza iniziale. Chi supervisiona deve anche riconoscere i segnali deboli, comprendere i limiti del processo e sapere quando attivare l’escalation. È una capacità ibrida che combina esperienza di dominio, lettura dei dati operativi e autorità decisionale.
Misurare il protocollo, oltre al modello
Le metriche tradizionali descrivono accuratezza, velocità e costo. Un sistema in produzione richiede anche indicatori sulla qualità della supervisione. Il tasso di correzione rivela quante proposte vengono modificate. La frequenza delle escalation mostra dove l’autonomia incontra difficoltà. Il tempo di intervento misura la capacità dell’organizzazione di reagire quando emerge un problema.
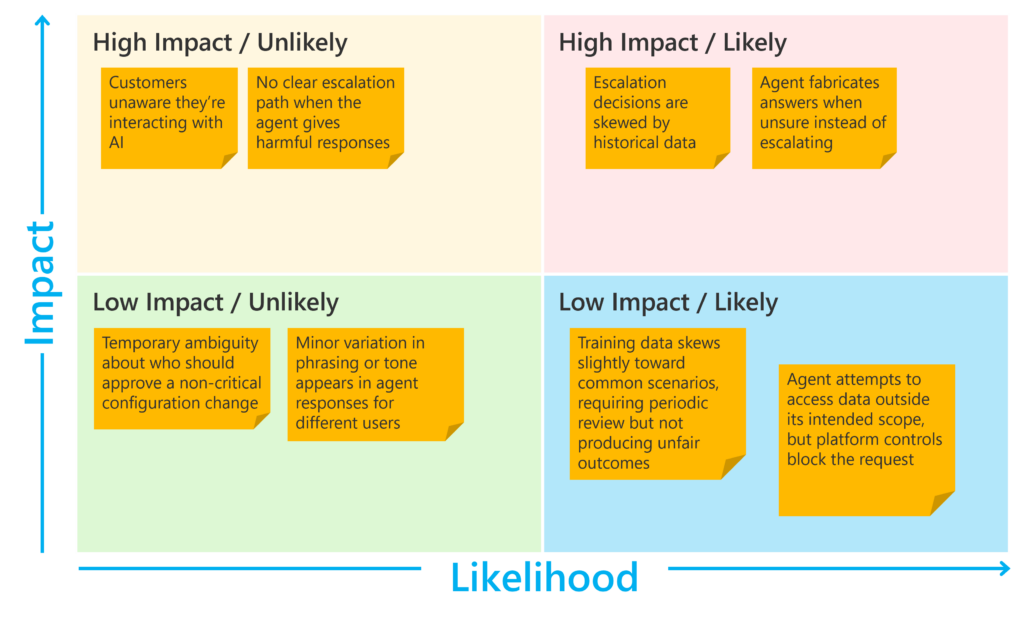
Questi dati aiutano a distinguere un incidente isolato da una debolezza strutturale. Se gli stessi errori tornano, il problema può riguardare le istruzioni, le fonti o il perimetro assegnato all’agente. Se le escalation restano aperte troppo a lungo, il collo di bottiglia risiede probabilmente nella catena decisionale. La supervisione diventa così osservabile e può essere migliorata con la stessa disciplina usata per il sistema tecnico.
La misura più interessante riguarda l’apprendimento organizzativo. Un protocollo maturo riduce la ripetizione degli incidenti perché ogni caso alimenta modifiche concrete. Il controllo smette di essere una barriera collocata alla fine del flusso e diventa un circuito che aggiorna regole, test e responsabilità.
La supervisione come vantaggio operativo
Le aziende che trattano la supervisione come un adempimento tardivo finiscono spesso per oscillare tra due estremi: autonomia concessa con leggerezza e blocco generalizzato dopo il primo incidente. Un protocollo definito in anticipo permette una crescita più stabile. I team sanno quali operazioni delegare, i responsabili conoscono le proprie leve e il management può valutare il rischio su dati osservabili.
Questo approccio accelera anche l’adozione. Regole chiare riducono le discussioni ripetitive e rendono più semplice estendere un progetto ad altri reparti. La fiducia nasce dalla possibilità di vedere, ricostruire e correggere il comportamento del sistema. Diventa una proprietà del processo aziendale, anziché una speranza riposta nel prossimo modello.
La maturità nell’uso dell’AI si riconoscerà sempre meno dalla quantità di strumenti attivati. Emergerà dalla qualità delle responsabilità costruite intorno a quegli strumenti. Quando ogni agente ha un perimetro, ogni anomalia trova un percorso e ogni decisione lascia una traccia, l’AI può entrare davvero nel lavoro quotidiano. A quel punto la supervisione cessa di sembrare un freno: diventa l’infrastruttura che rende possibile l’autonomia.
Fonti
- Microsoft Learn — Security and governance for Microsoft 365 Copilot
- Microsoft Learn — Human supervision for computer use
- Microsoft Learn — Security and governance maturity model
- OpenAI — How we think about safety and alignment
- AWS Prescriptive Guidance — Building an enterprise-ready generative AI platform on AWS
- AWS Well-Architected Framework — Generative AI Lens