Un preprint valuta 11 modelli e propone un certificato statistico per affidare le verifiche cliniche alle versioni quantizzate, ricorrendo al riferimento BF16 solo quando necessario.
Usare sempre un grande modello clinico alla massima precisione è un approccio semplice, costoso e poco elegante. Un nuovo studio disponibile su arXiv propone una strategia più intelligente: lasciare che una versione quantizzata gestisca le decisioni che può affrontare con sufficiente affidabilità statistica e passare al modello BF16 di riferimento soltanto nei casi che non ottengono la certificazione.
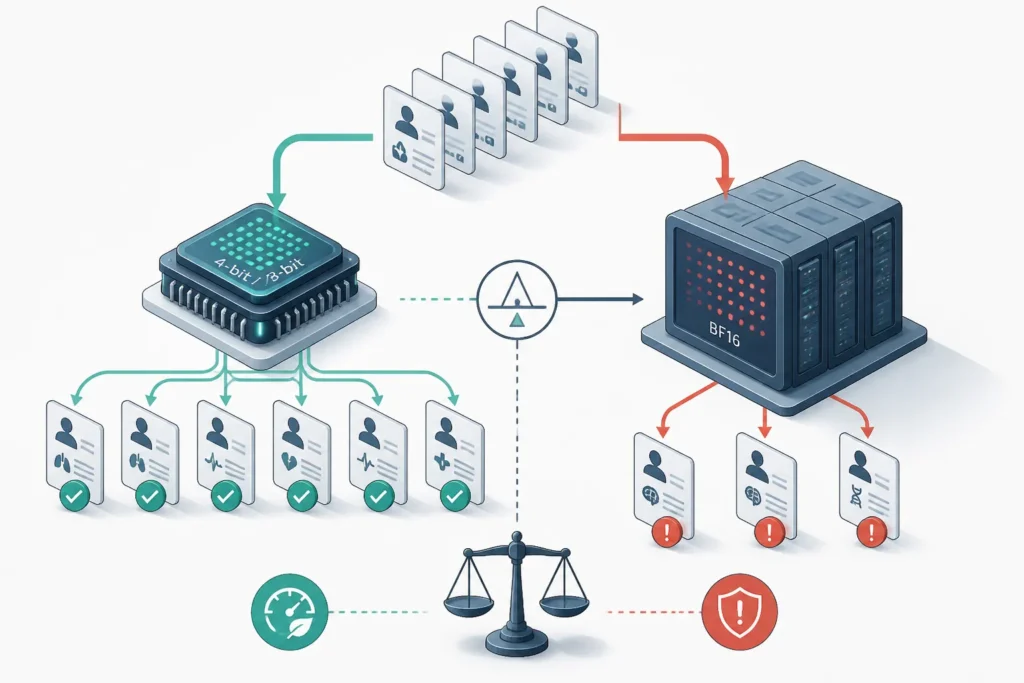
Il sistema si chiama CERTA ed è stato presentato da Ali H. Lazem e William Teahan. Il suo obiettivo riguarda un ostacolo concreto dell’AI clinica: i modelli più grandi possono richiedere infrastrutture multi-GPU, rendendo più difficile il deployment locale. CERTA trasforma la scelta della precisione numerica in una politica applicata alla singola decisione, invece di imporre la stessa configurazione a tutto il carico di lavoro.
La distinzione è importante. Un modello quantizzato non diventa necessariamente più piccolo per numero di parametri: un LLM da 72 miliardi di parametri resta tale nella propria architettura. Cambia la precisione usata per rappresentare i pesi, con configurazioni a 8 o 4 bit che possono ridurre memoria e costo operativo rispetto al riferimento BF16. Il guadagno arriva quindi da una rappresentazione più compatta e da un impiego selettivo della configurazione più pesante.
CERTA funziona come un selettore statistico. Per ogni decisione valuta se la risposta della configurazione quantizzata può sostituire quella del modello nativo secondo il criterio previsto dal certificato. Le decisioni che superano il controllo vengono servite dalla versione compressa; le altre vengono inoltrate al riferimento BF16. In pratica, la potenza di calcolo viene distribuita in base alla difficoltà osservata, invece di essere consumata uniformemente.
Gli autori hanno valutato 11 modelli instruction-tuned, sia generalisti sia adattati al dominio, appartenenti a tre famiglie e compresi tra 7 e 72 miliardi di parametri. L’esperimento comprende 2.500 decisioni di verifica clinica costruite a partire da contesti de-identificati relativi a 2.484 pazienti. Calibrazione e test sono stati separati anche a livello di paziente, evitando che lo stesso soggetto comparisse in entrambi gli insiemi.
I risultati operativi sull’8 bit sono particolarmente netti. Nell’analisi a maggiore potenza statistica, la quantizzazione round-to-nearest a 8 bit con storage BF16 ha gestito tra il 99,8% e il 100% delle decisioni di test per tutti gli 11 modelli. Solo una quota minima avrebbe quindi richiesto l’escalation alla configurazione di riferimento in quello specifico scenario sperimentale.
Il passaggio a 4 bit rende il quadro ancora più interessante sul fronte dell’efficienza. La frontiera selezionata per classe ha portato il costo di deployment ammortizzato, espresso in equivalenti BF16, al 25,8% per Qwen2.5-72B e al 27,3% per HuatuoGPT-o1-72B. La memoria di picco misurata è stata rispettivamente di 43,0 e 42,7 GB, valori inferiori alla capacità nominale di un singolo acceleratore da 48 GB.
Qui serve precisione nella lettura: lo studio non ha provato direttamente il deployment su quello specifico hardware. I numeri mostrano una compatibilità nominale sul piano della memoria, non una dimostrazione completa del comportamento del sistema in produzione. Con la procedura esatta split-sample, che include anche la selezione della configurazione nelle garanzie formali a campione finito, i costi equivalenti sono risultati pari al 26,7% e al 27,9%.
Gli autori hanno inoltre verificato le configurazioni NF4 selezionate su benchmark esterni per il riconoscimento di entità relative alle malattie, confrontandole con annotazioni umane. Su entrambi i dataset la variazione assoluta media dell’F1 è stata di 0,045, accompagnata però da differenze sostanziali tra i singoli modelli. È un promemoria utile: la quantizzazione può funzionare molto bene, mentre il risultato concreto continua a dipendere dal modello e dal compito.
La vera novità dello studio sta nel cambio di prospettiva. Il dibattito sull’efficienza degli LLM viene spesso ridotto alla scelta di una precisione fissa: BF16 per puntare alla massima fedeltà, 8 bit o 4 bit per risparmiare risorse. CERTA introduce una terza via, dinamica e verificabile, nella quale diverse configurazioni collaborano all’interno dello stesso processo.
Per sviluppatori e strutture che valutano applicazioni cliniche locali, una politica di questo tipo può rendere più plausibile l’impiego di modelli molto grandi senza assegnare a ogni richiesta il costo massimo. Il modello di riferimento rimane disponibile come livello superiore, mentre la maggior parte del traffico può essere assorbita dalla versione quantizzata quando il certificato lo consente.
Il perimetro resta quello studiato: decisioni di verifica clinica, specifici modelli e una procedura sperimentale che dovrà essere esaminata e replicata. Il preprint indica comunque una direzione concreta per l’AI applicata: l’efficienza più interessante potrebbe arrivare meno dalla corsa a un unico modello universale e più dalla capacità di decidere, caso per caso, quanta potenza serve davvero.
Fonti