Web, email, PDF e repository possono trasportare informazioni e istruzioni ostili nello stesso formato. Per gli agenti AI, leggere il mondo richiede un’infrastruttura di fiducia selettiva.
Un agente riceve un’email, apre il PDF allegato e aggiorna un ticket. Sembra un flusso lineare. In realtà, ciascun passaggio attraversa un confine di sicurezza: il contenuto consultato può includere informazioni utili, istruzioni legittime oppure frasi progettate per deviare il comportamento del sistema. Tutto viaggia attraverso lo stesso mezzo, il linguaggio.
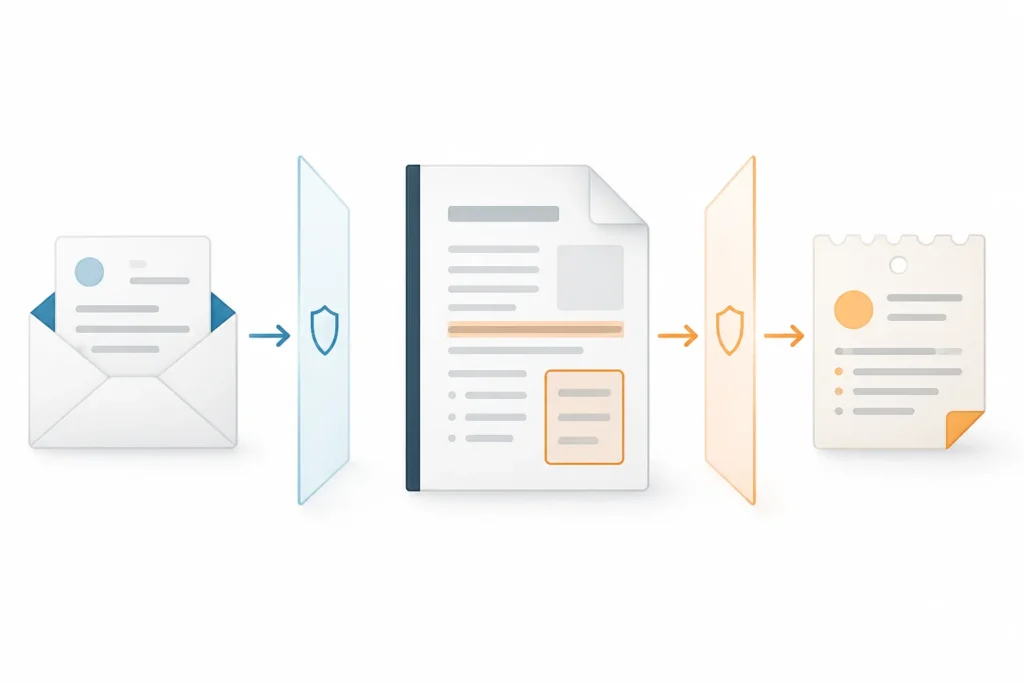
Questa sovrapposizione cambia il modo in cui dovremmo progettare i workflow AI. Una pipeline tradizionale acquisisce documenti e li tratta come materiale da elaborare. Un agente interpreta quel materiale, decide quali parti contano e può trasformarle in azioni. Il documento acquisisce così un potere operativo che prima apparteneva al software, alle policy e agli utenti autorizzati.
Il prompt injection è il segnale più evidente di questa frattura. La questione infrastrutturale è ancora più ampia: ogni sistema collegato a fonti esterne deve stabilire quale autorità concedere a ciò che legge.
Quando una fonte prova a diventare un comando
Nel prompt injection diretto, un utente tenta di modificare le priorità del modello attraverso la conversazione. Nella variante indiretta, l’istruzione ostile si trova dentro una pagina web, un allegato o un documento recuperato dal sistema. L’agente incontra quel testo mentre svolge un compito apparentemente ordinario.
Una frase rivolta al modello può essere nascosta tra contenuti pertinenti, presentata come una procedura oppure inserita in una sezione marginale del documento. Dal punto di vista linguistico possiede la stessa materia prima delle istruzioni autentiche. Un filtro sintattico può intercettare formule note; una manipolazione espressa in linguaggio naturale conserva però molte possibilità di variazione. La difesa efficace richiede quindi più livelli, dalla classificazione dell’input alla limitazione degli strumenti disponibili.
Il rischio cresce quando l’AI passa dalla consultazione all’esecuzione. Un assistente con accesso in sola lettura può produrre una sintesi distorta. Un agente collegato a posta elettronica, CRM e strumenti di pubblicazione può propagare l’errore, esporre informazioni o avviare operazioni. Lo stesso contenuto assume un peso diverso in base ai poteri assegnati al sistema.
Il confine tra dati e controllo diventa poroso
Nelle architetture software classiche, il piano di controllo stabilisce regole e permessi, mentre il piano dei dati trasporta le informazioni da elaborare. I modelli linguistici rendono questo confine più poroso perché dati e comandi possono condividere la forma di una frase.
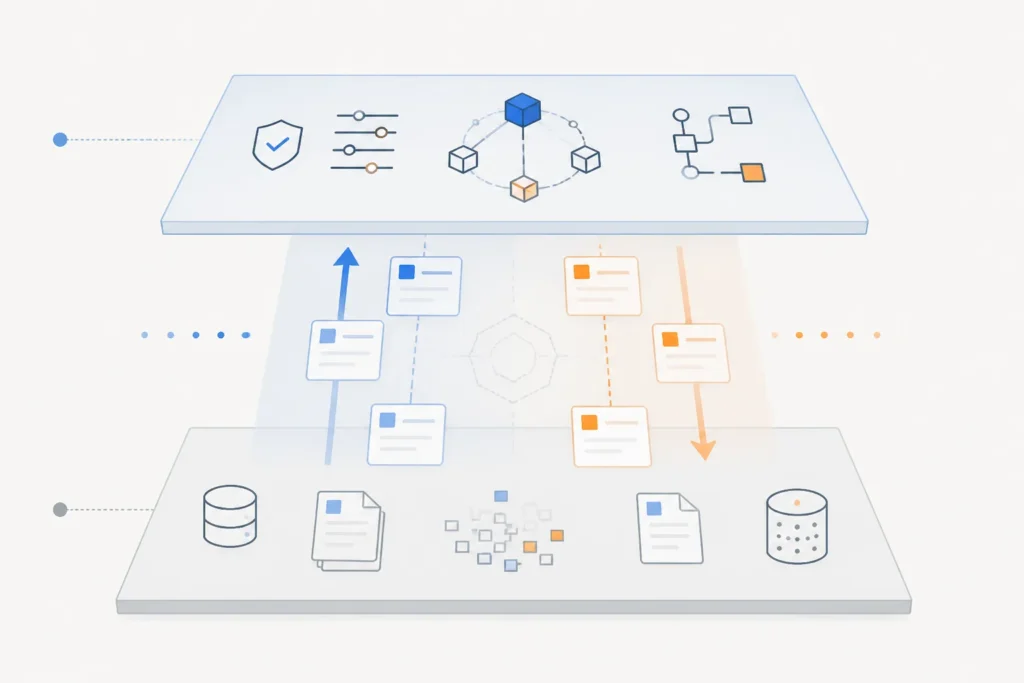
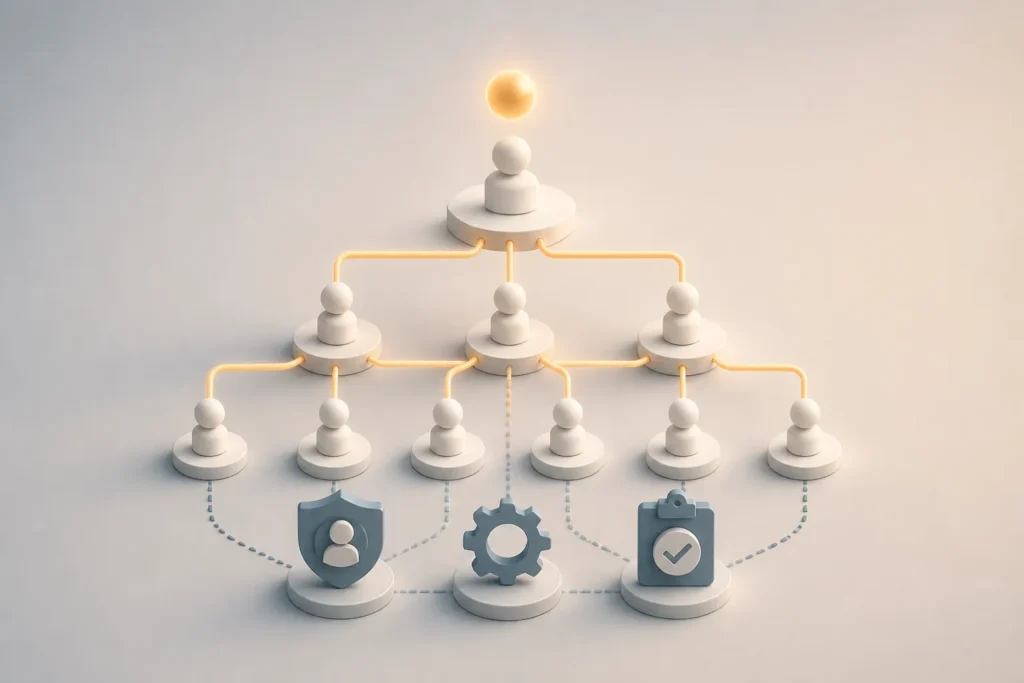
Un documento dovrebbe contribuire alla risposta con fatti, argomenti e contesto. Le istruzioni operative dovrebbero provenire dall’orchestratore, dalle policy o da un utente autorizzato. I metadati dovrebbero indicare origine, livello di fiducia e condizioni d’uso. Quando questi elementi vengono riversati in un unico contesto testuale, il modello deve ricostruire una gerarchia che l’infrastruttura ha lasciato implicita.
La progettazione robusta rende quella gerarchia visibile prima dell’inferenza. Ogni contenuto entra nel workflow con una provenienza, una categoria e un’autorità predefinita. Una pagina pubblica può fornire informazioni pertinenti e ricevere, allo stesso tempo, un potere operativo minimo. Un documento interno approvato può ottenere un livello superiore, entro un perimetro preciso. La fiducia diventa così una proprietà del flusso, invece di una supposizione incorporata nel prompt.
La pertinenza misura una cosa, l’autorità ne misura un’altra
I sistemi di retrieval cercano spesso i passaggi più vicini alla domanda dell’utente. Questo criterio migliora la rilevanza della risposta. L’autorità riguarda invece il diritto di influenzare il comportamento dell’agente. Un testo può essere estremamente pertinente e provenire da una fonte sconosciuta; può anche contenere indicazioni credibili sul tema e istruzioni abusive rivolte al sistema.
La fiducia selettiva separa queste dimensioni. Il motore di ricerca interno può recuperare il passaggio, mentre il livello di orchestrazione limita il modo in cui quel passaggio viene usato. Il contenuto contribuisce alla conoscenza disponibile e resta escluso dalla definizione degli obiettivi, dalla modifica dei permessi e dalla scelta autonoma di nuovi strumenti.
Questa logica dovrebbe accompagnare anche i contenuti derivati. Un riassunto generato da una fonte a bassa fiducia appare più ordinato e autorevole dell’originale; il rischio di provenienza resta presente. Se quel riassunto passa a un secondo agente privo di informazioni sull’origine, la catena perde un segnale essenziale. Etichette e metadati devono quindi viaggiare insieme al testo attraverso trasformazioni, sintesi e passaggi tra agenti.
Redazioni, assistenza e sviluppo condividono lo stesso problema
In una redazione, un agente può raccogliere fonti, estrarre dichiarazioni e preparare una bozza. Una pagina manipolativa potrebbe alterare le priorità della ricerca o spingere il sistema a ignorare materiale rilevante. Il workflow editoriale guadagna solidità quando conserva la provenienza di ogni passaggio e assegna alla fonte il ruolo di materiale documentale, lasciando le decisioni di pubblicazione a un livello separato.
Nel customer support, email e allegati arrivano da soggetti esterni e possono entrare direttamente nel contesto dell’assistente. Il sistema può classificare la richiesta e proporre una risposta con privilegi ridotti. Rimborsi, modifiche contrattuali e accesso ai dati richiedono un percorso autorizzativo distinto. La sicurezza emerge dalla relazione tra contenuto e capacità disponibili.
Un coding agent incontra lo stesso schema dentro issue, commenti e file README. Questi elementi aiutano a comprendere il progetto e possono anche tentare di orientare l’esecuzione. Ambienti isolati, credenziali temporanee e revisioni prima del merge riducono la portata di un’eventuale manipolazione. Il modello rimane lo stesso; cambia il raggio delle conseguenze.
Dalla pipeline di lettura all’architettura di fiducia
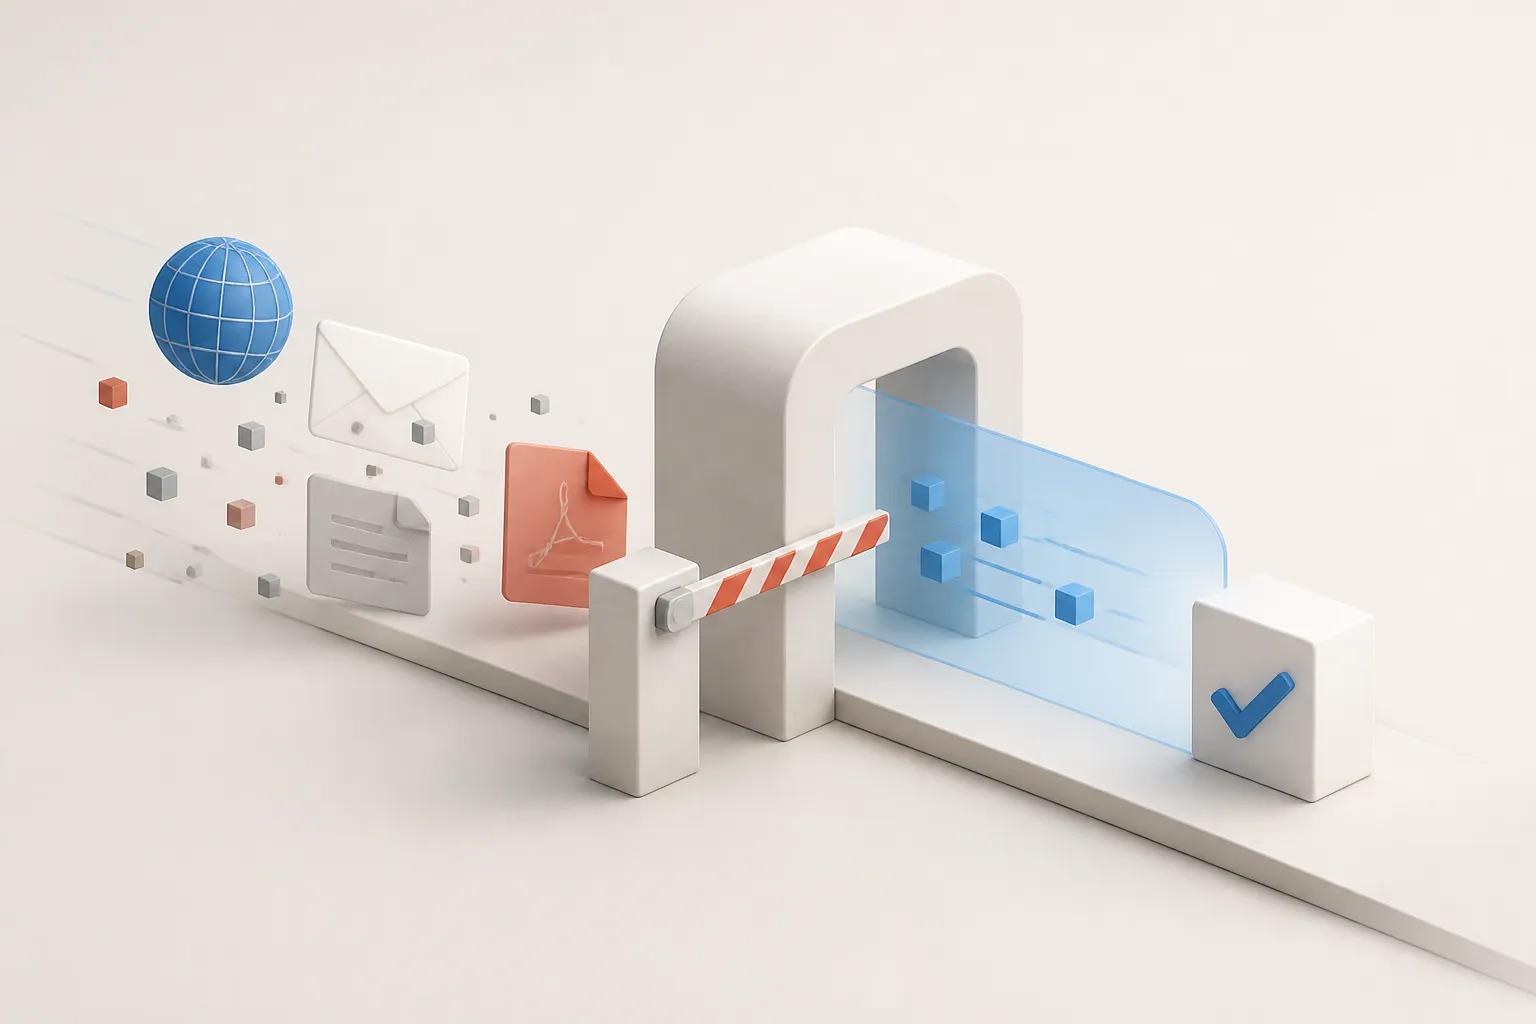
La prima trasformazione riguarda l’ingresso dei contenuti. Web, documenti e messaggi dovrebbero attraversare una zona di acquisizione separata, dove il sistema registra provenienza, formato e percorso di arrivo. La normalizzazione rimuove elementi attivi e riduce alcune superfici di attacco. La successiva analisi semantica cerca segnali di istruzioni rivolte al modello, conflitti con il compito e richieste di accesso estranee allo scopo dichiarato.
La quarantena riduce l’esposizione e resta una componente parziale. Un testo perfettamente leggibile può contenere una manipolazione espressa con grande naturalezza. Per questo le indicazioni di OWASP convergono su una difesa stratificata: separazione tra dati e istruzioni, limiti sugli strumenti, controllo dell’output e gestione prudente dei privilegi.
La memoria richiede un’attenzione specifica. Un contenuto esterno inserito automaticamente nella memoria persistente può influenzare molte attività successive. Il contesto temporaneo offre un perimetro più controllabile. La promozione di un’informazione a memoria durevole dovrebbe dipendere da provenienza, verifica e utilità futura, con la possibilità di rintracciare e rimuovere ciò che è stato acquisito.
Anche i log assumono una funzione nuova. Registrare la risposta finale offre una visione incompleta. Servono tracce delle fonti recuperate, dei permessi concessi, degli strumenti invocati e dei checkpoint attraversati. Questa osservabilità permette di ricostruire come un contenuto sia diventato una decisione e di correggere il workflow dopo un comportamento anomalo.
La supervisione funziona meglio nei punti di trasformazione
La revisione umana di ogni documento renderebbe molti workflow troppo lenti. I checkpoint più efficaci si concentrano nei passaggi in cui il testo acquisisce conseguenze: pubblicazione, invio di messaggi e modifica di dati. Il sistema può leggere e preparare materiale con ampia autonomia, mentre le azioni ad alto impatto attraversano soglie esplicite.
Questa impostazione collega sicurezza e usabilità. Un agente bloccato a ogni passaggio offre poco valore operativo. Un agente con poteri estesi e confini impliciti accumula rischio. La granularità dei permessi consente di espandere le capacità in modo progressivo, osservando il comportamento reale e mantenendo reversibili le operazioni più delicate.
La cornice proposta dal NIST sulla fiducia e sulla resilienza aiuta a leggere il prompt injection come tema organizzativo. Il problema coinvolge responsabilità, accessi, monitoraggio e risposta agli incidenti. Il prompt rimane una componente del sistema; la robustezza dipende dall’architettura che lo circonda.
Il vantaggio competitivo sarà saper leggere con prudenza
Le demo premiano spesso l’agente capace di consultare più fonti e usare più strumenti. Nei prodotti reali conta anche la capacità di attribuire livelli diversi di fiducia, conservare la provenienza e limitare il passaggio dalla lettura all’azione. Un modello molto fluente accelera il traffico informativo. Una buona architettura decide quale traffico può attraversare il confine e fin dove può arrivare.
Per aziende e team prodotto, la valutazione di un sistema agentico dovrebbe includere il trattamento degli input esterni, l’eredità della fiducia nei contenuti derivati e la separazione dei privilegi. Queste proprietà raccontano la maturità del prodotto almeno quanto la qualità delle risposte in una conversazione controllata.
L’AI che legge il mondo ha bisogno di una dogana: identifica l’origine, ispeziona il carico, assegna condizioni di transito e limita la destinazione. La prossima generazione di agenti utili verrà giudicata sia per l’ampiezza di ciò che sa consultare sia per la cura con cui trasforma una fonte in un’azione.
Fonti
- OpenAI – Prompt injections
- OpenAI – Designing agents to resist prompt injection
- OWASP – LLM Prompt Injection Prevention Cheat Sheet
- OWASP – MCP Security Cheat Sheet
- NIST – AI Risk Management Framework