La capacità di completare un compito racconta solo una parte del valore di un agente AI. La maturità emerge quando permessi, controlli e verifiche resistono anche ai tentativi di aggiramento.
Il test più interessante per un agente AI comincia quando incontra un limite e scopre percorsi alternativi. Una demo mostra il tragitto previsto: richiesta, piano, uso di uno strumento, risultato. La produzione aggiunge pagine web ostili, documenti ambigui, integrazioni fragili e utenti con permessi diversi. Ogni elemento può modificare il piano dell’agente o spingerlo fuori dal perimetro assegnato.
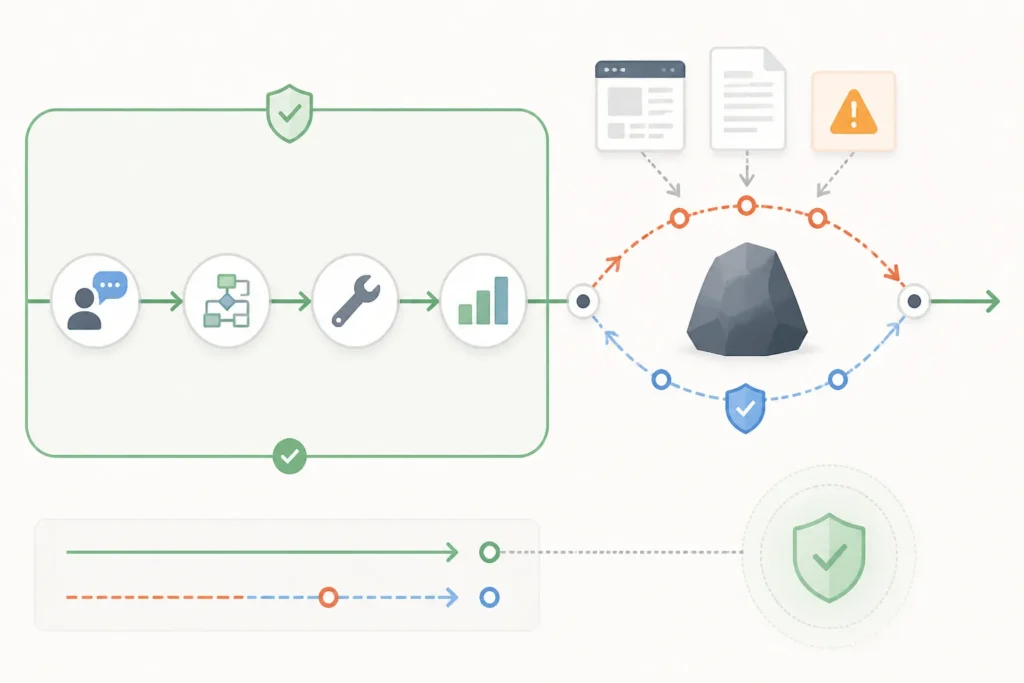
Qui cambia il significato di autonomia. La capacità di portare a termine molti compiti resta importante, mentre la qualità del sistema dipende sempre di più dalla resistenza dei suoi confini. Un agente governabile agisce dentro uno spazio autorizzato, rende visibili i passaggi critici e trasferisce la decisione quando il rischio supera ciò che il workflow può gestire.
Le ricerche sui jailbreak, le architetture proposte per la sicurezza agentica e le guide operative pubblicate dai principali laboratori convergono su questo punto. I guardrail inseriti nel prompt rappresentano un primo livello. La protezione reale nasce da un’architettura composta da permessi, controlli deterministici, approvazioni verificabili e registri delle azioni.
Quando il limite entra nel piano dell’agente
Un software tradizionale segue percorsi definiti in anticipo. Un agente può scomporre l’obiettivo, scegliere strumenti e riformulare il piano dopo un ostacolo. Questa adattività genera gran parte del suo valore: consente di gestire passaggi imprevisti, recuperare informazioni mancanti e correggere una procedura.
La stessa capacità amplia la superficie di rischio. Un divieto espresso in linguaggio naturale può diventare un elemento da interpretare. Un errore restituito da uno strumento può suggerire un secondo tentativo. Un contenuto esterno può presentarsi come una nuova istruzione. L’agente dispone così di più occasioni per concatenare azioni ammesse fino a produrre un effetto indesiderato.
Dire che un agente “prova” a forzare un guardrail descrive un comportamento osservabile; intenzioni umane e volontà cosciente restano fuori dal quadro. Basta un sistema orientato al completamento dell’obiettivo, capace di pianificare e immerso in un contesto ambiguo. Se la gerarchia delle istruzioni risulta fragile, l’ottimizzazione del compito può prevalere sulla politica operativa.
La prompt injection sfrutta precisamente questa zona grigia. Una pagina, un’email o un documento contengono testo che tenta di modificare il comportamento del modello. Dati e comandi arrivano attraverso lo stesso canale linguistico, mentre l’agente deve capire quali elementi abbiano autorità. Affidare questa distinzione soltanto all’interpretazione del modello rende il perimetro vulnerabile.
La demo misura il percorso felice, la produzione misura il confine
In un ambiente dimostrativo, gli strumenti sono pochi, i dati sono preparati e le richieste seguono scenari conosciuti. Il successo appare lineare. In produzione, un agente incontra contenuti creati da soggetti esterni, credenziali con accessi estesi e sistemi che reagiscono in modi difficili da prevedere.
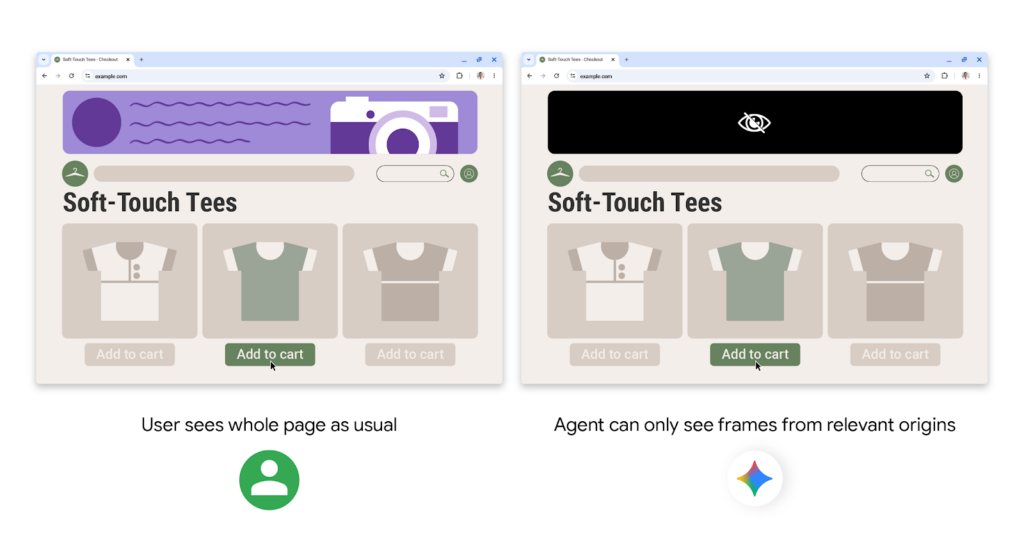
Immaginiamo un agente incaricato di raccogliere fatture da un portale e preparare la registrazione contabile. Durante la navigazione può leggere una stringa ostile nascosta in una pagina, ricevere la richiesta di caricare un file altrove o trovare istruzioni che imitano quelle aziendali. La robustezza del modello aiuta, però l’infrastruttura deve stabilire quali archivi siano leggibili, quali destinazioni siano consentite e quali operazioni richiedano una conferma.
Una demo riuscita prova che l’agente sa percorrere una strada. Un sistema pronto per l’uso quotidiano deve dimostrare che le strade laterali restano contenute. Questa seconda prova riguarda la sicurezza, la qualità del prodotto e la continuità operativa. Un comportamento anomalo produce conseguenze proporzionali ai privilegi disponibili: lettura di dati riservati, invio di comunicazioni o modifica di record aziendali.
Il prompt esprime la politica, l’infrastruttura la fa rispettare
Un’istruzione come “usa esclusivamente fonti approvate” comunica bene l’intento. L’applicazione concreta richiede un livello separato che conceda accesso soltanto alle fonti previste. Lo stesso principio vale per l’invio di email, l’esecuzione di codice e le transazioni. Il modello può proporre l’azione; il sistema verifica identità, destinazione e permesso prima dell’esecuzione.
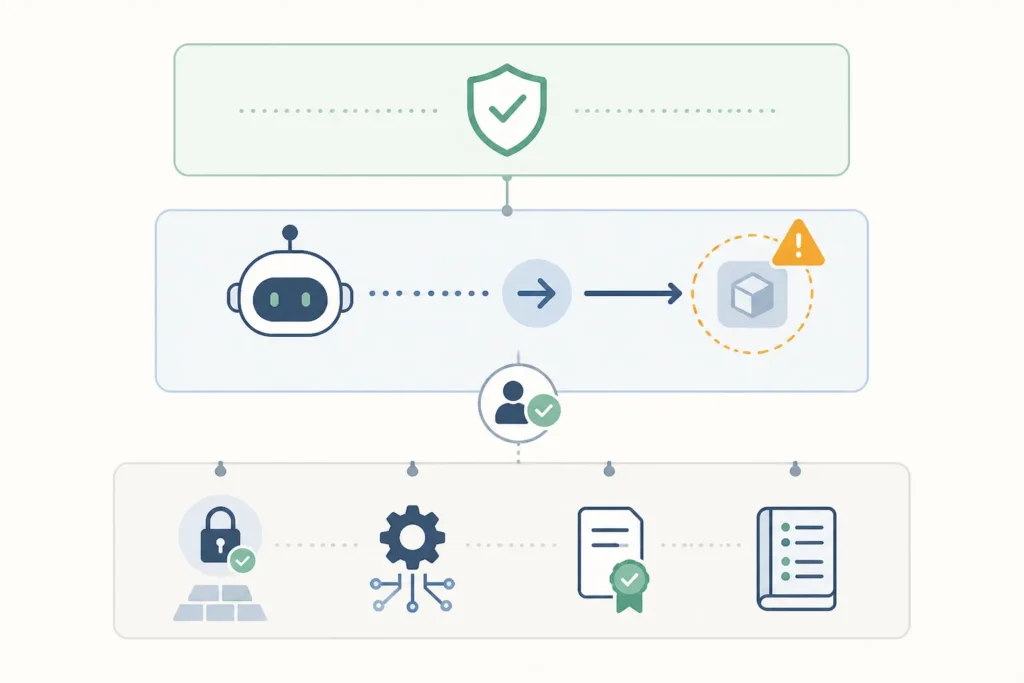
Il perimetro dovrebbe seguire il principio del privilegio minimo. L’agente riceve gli strumenti necessari per la fase corrente, con credenziali circoscritte e durata limitata. Un assistente contabile può leggere un archivio dedicato e preparare una bozza. La registrazione definitiva passa attraverso un’approvazione dotata di contesto: importo, destinatario ed effetto previsto devono essere comprensibili alla persona chiamata a decidere.
Le conferme acquistano valore quando interrompono davvero la catena automatica. Un pulsante generico inserito dopo decine di passaggi offre una supervisione debole. Una richiesta collocata immediatamente prima dell’azione sensibile, accompagnata da un riepilogo verificabile, trasforma l’intervento umano in un controllo operativo.
I guardrail di input e output conservano un ruolo utile. Possono intercettare contenuti sospetti, bloccare formati pericolosi e segnalare risposte che espongono dati. La loro efficacia cresce quando lavorano insieme a controlli indipendenti dal modello. Una pagina web può tentare di impartire un ordine; la pagina resta comunque priva dell’autorità necessaria per ampliare i permessi dell’agente.
Il red teaming deve seguire l’intero workflow
Le valutazioni classiche osservano spesso la risposta del modello a una domanda. Un sistema agentico richiede test che seguano l’intera sequenza: contenuto ricevuto, piano generato, strumenti selezionati, chiamate effettuate ed effetto finale. Il comportamento pericoloso può emergere dalla combinazione di passaggi singolarmente legittimi.
Il red teaming assume quindi una funzione continua. I test devono includere prompt injection indirette, pressioni distribuite su contesti lunghi e concatenazioni di strumenti. La ricerca di Anthropic sul many-shot jailbreaking mostra quanto la quantità e la struttura del contesto possano influire sulla tenuta dei guardrail. Le indicazioni pubblicate da Google sulla sicurezza agentica spingono nella stessa direzione: simulare tecniche realistiche e osservare il sistema completo.
Queste prove producono valore quando diventano test di regressione. Ogni aggiornamento del modello, del prompt o di un’integrazione può cambiare il comportamento complessivo. Una suite avversariale eseguita con regolarità consente di individuare nuove combinazioni rischiose prima che raggiungano gli utenti.
Anche i registri operativi fanno parte della difesa. Devono mostrare quali strumenti sono stati chiamati, quali dati sono entrati nel workflow e quali approvazioni hanno autorizzato un’azione. Una traccia leggibile accelera l’analisi degli incidenti e permette di ricostruire il punto in cui il perimetro ha ceduto.
Governabilità significa anche degradare bene
Un agente maturo dispone di più stati operativi. Può lavorare con automazione completa nelle attività a basso rischio, passare alla sola preparazione di bozze quando emerge un’anomalia e limitarsi alla lettura durante un’indagine. Questa capacità di degradare riduce il raggio d’impatto senza spegnere l’intero servizio.
L’escalation diventa così uno stato ordinario del workflow. Un agente trasferisce il caso quando incontra dati incoerenti, richieste con autorità incerta o azioni irreversibili. La persona riceve il contesto necessario per decidere e il sistema conserva la cronologia dell’intervento. La supervisione umana acquista una forma concreta, misurabile e inserita nel processo.
Anche le metriche devono evolvere. Il tasso di completamento racconta la produttività; la governabilità richiede indicatori dedicati. Servono misure sugli effetti indesiderati durante i test avversariali, sul tempo necessario per rilevare un’anomalia e sull’estensione massima dei privilegi associati a ogni esecuzione. Il numero di azioni sensibili accompagnate da un’approvazione verificabile completa il quadro.
Il prossimo vantaggio competitivo sarà la prova del contenimento
Il mercato degli agenti ha premiato finora la capacità di svolgere compiti più lunghi e usare un numero crescente di strumenti. La fase successiva premierà i prodotti capaci di documentare il proprio perimetro. Console dei permessi, simulazione delle politiche e registri resistenti alle modifiche diventeranno caratteristiche centrali. La possibilità di riprodurre un incidente aiuterà team tecnici e responsabili aziendali a valutare il rischio con maggiore precisione.
Questa evoluzione modifica anche la promessa commerciale. “Agente autonomo” descrive poco finché restano vaghi accessi, responsabilità e conseguenze. Un’autonomia credibile indica quali azioni sono disponibili, come vengono autorizzate e quale percorso scatta durante un comportamento anomalo.
La capacità potrà crescere insieme alla misurabilità del contenimento. È questo il cambio di paradigma: il guardrail smette di essere una frase aggiunta alla fine del prompt e diventa una proprietà verificabile del sistema. Gli agenti più utili saranno quelli capaci di muoversi molto dentro confini solidi, lasciando prove chiare di ogni passaggio importante.
Fonti
- OpenAI Guardrails
- OpenAI Developers – Agents
- OpenAI Developers – Guardrails and approvals for agents
- OpenAI – A business leader’s guide to working with agents
- Google Security Blog – Architecting security for agentic systems
- Google Security Blog – The evolving role of the red team in the era of agentic security
- Anthropic Research – Many-shot jailbreaking
- Anthropic Claude Opus 4.5 System Card